Τα παραδοσιακά συστήματα προστασίας (guardrails) για πράκτορες μεγάλων γλωσσικών μοντέλων (LLM agents) λειτουργούν συνήθως ως δυαδικοί ταξινομητές: αν το περιεχόμενο κριθεί μη ασφαλές, απλώς αποκλείεται, αναγκάζοντας τους οργανισμούς να απορρίπτουν τα αποτελέσματα και να ξεκινούν τη διαδικασία από την αρχή. Μια νέα έρευνα που δημοσιεύθηκε στο arXiv παρουσιάζει το RAIL Guard, έναν αγωγό υπεύθυνης Τεχνητής Νοημοσύνης κλειστού βρόχου που επιδιώκει να αλλάξει αυτό το παράδειγμα.
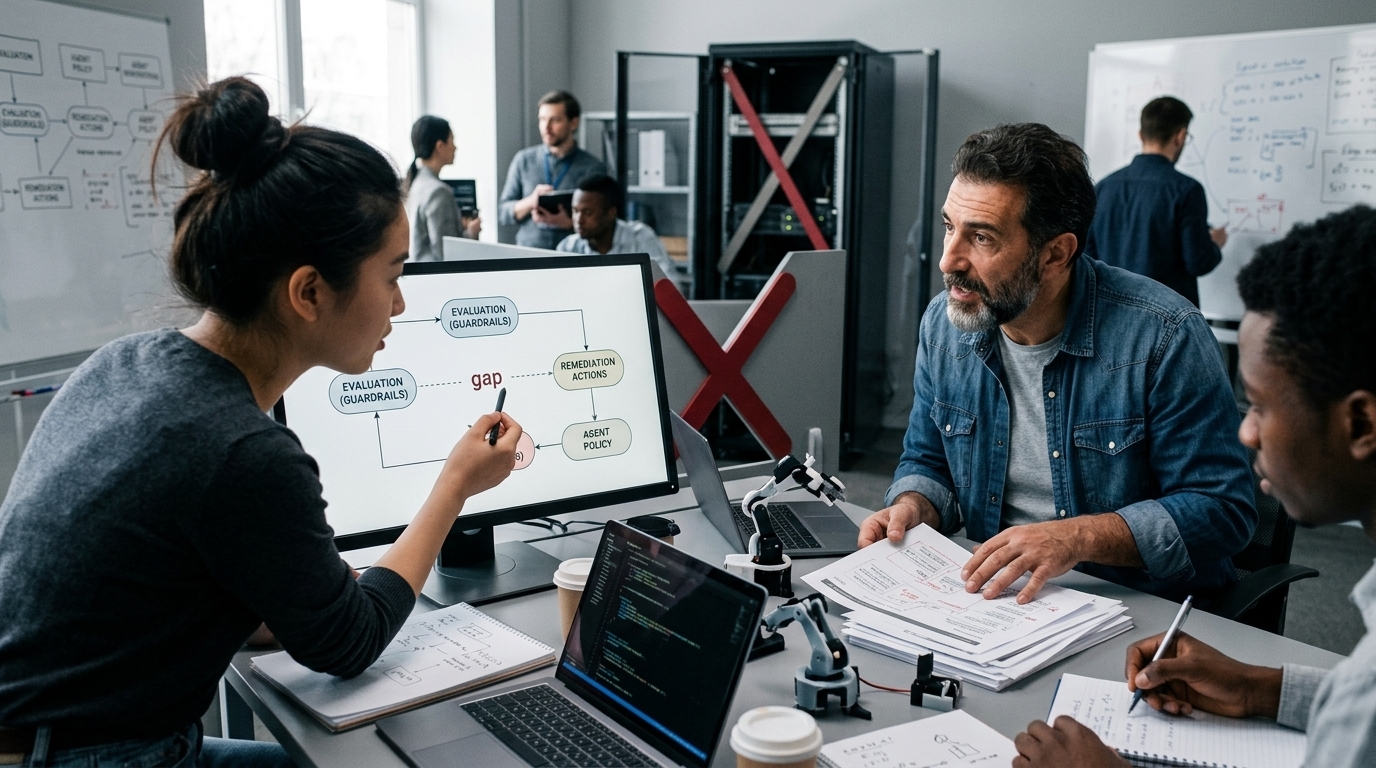
Η διαδικασία Αξιολόγησης-Επανασυγγραφής-Επαναξιολόγησης
Το RAIL Guard αξιολογεί τις εξόδους των μοντέλων σε οκτώ μετρήσιμες διαστάσεις. Αντί για έναν απλό αποκλεισμό, το σύστημα χρησιμοποιεί έναν βρόχο «αξιολόγησης-επανασυγγραφής-επαναξιολόγησης» για να διορθώσει επαναληπτικά τις προβληματικές εξόδους. Σύμφωνα με τα ευρήματα της μελέτης σε τέσσερα κορυφαία LLM και χιλιάδες σενάρια:
- Η αποκατάσταση κλειστού βρόχου πέτυχε ποσοστό σύγκλισης 96,9%, έναντι μόλις 49,1% της μεθόδου «αποκλεισμού και επανάληψης».
- Η αυτο-επιδιόρθωση βάσει ανατροφοδότησης (feedback-driven self-repair) πέτυχε 86,6% σύγκλιση στις διορθώσιμες διαστάσεις χωρίς σημαντική απώλεια χρηστικότητας (p = 0,177).
- Η αξιολόγηση πριν από την κλήση εργαλείων (pre-tool-call) μείωσε τις μη ασφαλείς εκτελέσεις κατά 33% (p = 0,007), χωρίς να επηρεάσει την ολοκλήρωση των εργασιών.
Δομικά έναντι Διορθώσιμων Προβλημάτων
Η έρευνα αναδεικνύει μια κρίσιμη διάκριση μεταξύ των διαστάσεων που επιδέχονται διόρθωση και εκείνων που είναι δομικές. Ενώ πολλά ζητήματα περιεχομένου επιλύονται μέσω του αλγοριθμικού βρόχου, θέματα όπως η Διαφάνεια (93,0% αποτυχία), η Λογοδοσία (92,8%) και η Συμπεριληπτικότητα (82,5%) παρουσιάζουν υψηλά ποσοστά αποτυχίας που απαιτούν αρχιτεκτονικές και όχι απλώς αλγοριθμικές λύσεις. Το σύστημα RAIL Guard είναι πλέον διαθέσιμο ως SDK ανοιχτού κώδικα.