Στον ταχύτατα εξελισσόμενο κόσμο της Τεχνητής Νοημοσύνης, το 2026 έχει αναδειχθεί ως το έτος της «πολυτροπικότητας» (multimodality). Τα Μεγάλα Γλωσσικά Μοντέλα (LLMs) δεν περιορίζονται πλέον στο κείμενο· επεξεργάζονται εικόνες, βίντεο και ήχο με μια φαινομενική ευχέρεια που προκαλεί δέος. Ωστόσο, μια νέα ερευνητική εργασία που δημοσιεύθηκε στο ArXiv (cs.AI — 2606.26348) έρχεται να ταράξει τα νερά, θέτοντας ένα κρίσιμο ερώτημα: Αξιολογούμε σωστά αυτά τα συστήματα ή απλώς μετράμε την ικανότητά τους να αποστηθίζουν δεδομένα;
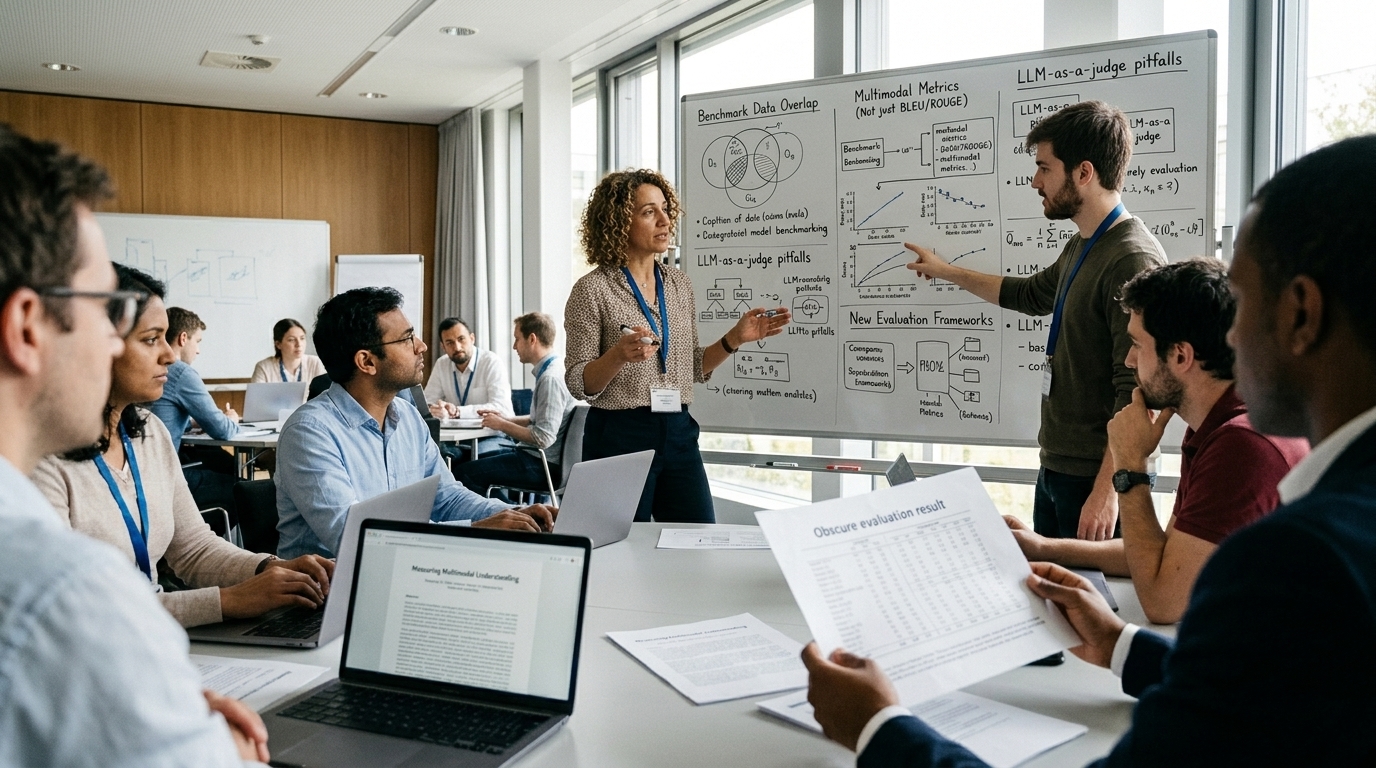
Η έρευνα υπογραμμίζει ένα αυξανόμενο χάσμα μεταξύ των εντυπωσιακών επιδείξεων των εταιρειών και της πραγματικής ικανότητας των μοντέλων να κατανοούν τον κόσμο. Ενώ τα benchmarks (δοκιμασίες αξιολόγησης) δείχνουν διαρκή άνοδο των επιδόσεων, η ερευνητική κοινότητα αρχίζει να συνειδητοποιεί ότι οι μετρήσεις μας είναι συχνά ελλιπείς, μεροληπτικές ή εύκολα «χειραγωγήσιμες» από μοντέλα που μαθαίνουν να αναγνωρίζουν μοτίβα χωρίς πραγματική λογική σκέψη.
Η Ψευδαίσθηση της Κατανόησης και το Πρόβλημα των Benchmarks
Το κύριο πρόβλημα που εντοπίζει η μελέτη είναι η εξάρτηση από στατικές εικόνες και απλές ερωταποκρίσεις. Τα περισσότερα τρέχοντα benchmarks, όπως το MMBench ή το MMMU, επικεντρώνονται σε μεμονωμένα στιγμιότυπα. Ωστόσο, η ανθρώπινη αντίληψη είναι δυναμική. Ένα μοντέλο μπορεί να αναγνωρίσει μια γάτα σε μια φωτογραφία, αλλά αποτυγχάνει παταγωδώς να κατανοήσει την αιτιώδη συνάφεια σε ένα βίντεο όπου η γάτα ρίχνει ένα βάζο από το τραπέζι.
Επιπλέον, υπάρχει το φαινόμενο του «γλωσσικού προκαταλήμματος» (language prior). Πολλά πολυτροπικά μοντέλα (MLLMs) απαντούν σωστά σε ερωτήσεις σχετικά με μια εικόνα χωρίς καν να την «κοιτάξουν», βασιζόμενα αποκλειστικά στις γνώσεις που έχουν αποκτήσει από το κείμενο κατά την εκπαίδευσή τους. Αν ρωτήσετε «Τι χρώμα είναι ο ουρανός;» σε μια φωτογραφία με αφύσικα κόκκινο ουρανό, το μοντέλο συχνά θα απαντήσει «μπλε», αποδεικνύοντας ότι η οπτική πληροφορία αγνοείται υπέρ των κειμενικών στατιστικών πιθανοτήτων.
Το Χάσμα στη Χρονική και Χωρική Λογική
Η έρευνα δίνει ιδιαίτερη έμφαση στην έλλειψη αξιολόγησης της χρονικής (temporal) και χωρικής (spatial) λογικής. Στην περίπτωση του βίντεο, η πρόκληση δεν είναι μόνο η αναγνώριση αντικειμένων, αλλά η κατανόηση της αλληλουχίας των γεγονότων. Τα τρέχοντα συστήματα αξιολόγησης σπάνια δοκιμάζουν αν ένα μοντέλο μπορεί να προβλέψει τι θα συμβεί στη συνέχεια ή αν μπορεί να αντιληφθεί την έννοια του «πριν» και του «μετά» σε μια σύνθετη δράση.
Αντίστοιχα, η χωρική κατανόηση παραμένει προβληματική. Τα μοντέλα συχνά δυσκολεύονται να προσδιορίσουν τις ακριβείς σχέσεις μεταξύ αντικειμένων (π.χ. «το κλειδί είναι αριστερά από το βιβλίο αλλά πίσω από το τηλέφωνο»). Χωρίς benchmarks που να απαιτούν ακριβή γεωμετρική και τοπολογική λογική, δημιουργούμε μοντέλα που είναι «οπτικά εγγράμματα» αλλά «χωρικά τυφλά».
Ηθικές Προεκτάσεις και Πολυτροπικές Ψευδαισθήσεις
Μια άλλη κρίσιμη διάσταση που επισημαίνει το ArXiv 2606.26348 είναι οι «πολυτροπικές ψευδαισθήσεις» (multimodal hallucinations). Πρόκειται για περιπτώσεις όπου το μοντέλο περιγράφει με απόλυτη βεβαιότητα αντικείμενα ή λεπτομέρειες που δεν υπάρχουν στην εικόνα ή το βίντεο. Η αξιολόγηση αυτών των σφαλμάτων είναι εξαιρετικά δύσκολη, καθώς απαιτεί πολύπλοκα συστήματα ελέγχου που συχνά είναι ακριβότερα από το ίδιο το μοντέλο που εξετάζεται.
Η μελέτη καταλήγει στο συμπέρασμα ότι χρειαζόμαστε μια ριζική αναθεώρηση του τρόπου με τον οποίο δοκιμάζουμε την AI. Αντί για απλές ερωτήσεις πολλαπλής επιλογής, χρειαζόμαστε διαδραστικά περιβάλλοντα αξιολόγησης όπου η AI πρέπει να εκτελέσει εργασίες που απαιτούν πραγματική συνέργεια μεταξύ των αισθήσεων. Η εμπιστοσύνη στην Τεχνητή Νοημοσύνη δεν μπορεί να βασίζεται σε «μαγειρεμένα» νούμερα, αλλά στην αποδεδειγμένη ικανότητα αντιμετώπισης της πολυπλοκότητας του πραγματικού κόσμου.