Στον πυρήνα της ανάπτυξης των μεγάλων γλωσσικών μοντέλων (LLMs) βρίσκεται μια συχνά παραβλεπόμενη αλλά κρίσιμη διαδικασία: ο καθορισμός του τι είναι «ασφαλές» και τι «επικίνδυνο». Αυτές οι πολιτικές ασφαλείας (Safety Policies) αποτελούν το σύνταγμα πάνω στο οποίο εκπαιδεύονται οι ψηφιακοί βοηθοί μας. Ωστόσο, η εφαρμογή αυτών των κανόνων από ανθρώπους σχολιαστές (annotators) αποδεικνύεται μια χαοτική διαδικασία. Μια πρόσφατη μελέτη που δημοσιεύθηκε στο ArXiv (cs.AI) με τίτλο «Understanding Annotator Safety Policy with Interpretability» φέρνει στο φως τις βαθιές ρωγμές σε αυτό το οικοδόμημα και προτείνει μια ριζοσπαστική λύση μέσω της ερμηνευσιμότητας.
Το Χάσμα της Αντίληψης: Γιατί οι Σχολιαστές Διαφωνούν
Η διαφωνία μεταξύ των σχολιαστών δεδομένων δεν είναι απλώς ένα στατιστικό σφάλμα· είναι το σύμπτωμα μιας βαθύτερης κρίσης ορισμών. Η έρευνα επισημαίνει ότι οι διαφωνίες πηγάζουν από τρεις κύριους πυλώνες. Πρώτον, υπάρχουν οι λειτουργικές αστοχίες, όπου οι σχολιαστές απλώς παρερμηνεύουν τις οδηγίες λόγω κόπωσης ή πολυπλοκότητας. Δεύτερον, υπάρχει η εγγενής ασάφεια του περιεχομένου — φράσεις που ισορροπούν στο όριο της ειρωνείας ή της ρητορικής μίσους. Τρίτον, και ίσως το πιο σημαντικό, είναι οι υποκειμενικές αξίες και οι πολιτισμικές διαφορές.
Όταν ένας σχολιαστής στην Καλιφόρνια και ένας στο Ναϊρόμπι καλούνται να αξιολογήσουν το ίδιο κείμενο, οι ηθικές τους πυξίδες συχνά δείχνουν σε διαφορετικές κατευθύνσεις. Μέχρι σήμερα, η βιομηχανία της Τεχνητής Νοημοσύνης αντιμετώπιζε αυτές τις διαφωνίες με τη «λογική της πλειοψηφίας» (majority voting), μια προσέγγιση που συχνά αποσιωπά τις αποχρώσεις και οδηγεί σε μοντέλα που στερούνται πολιτισμικής νοημοσύνης. Η νέα μελέτη υποστηρίζει ότι πρέπει να σταματήσουμε να βλέπουμε τη διαφωνία ως πρόβλημα που πρέπει να εξαλειφθεί και να αρχίσουμε να την αντιμετωπίζουμε ως πηγή πληροφορίας.
Η Ερμηνευσιμότητα ως Διαγνωστικό Εργαλείο
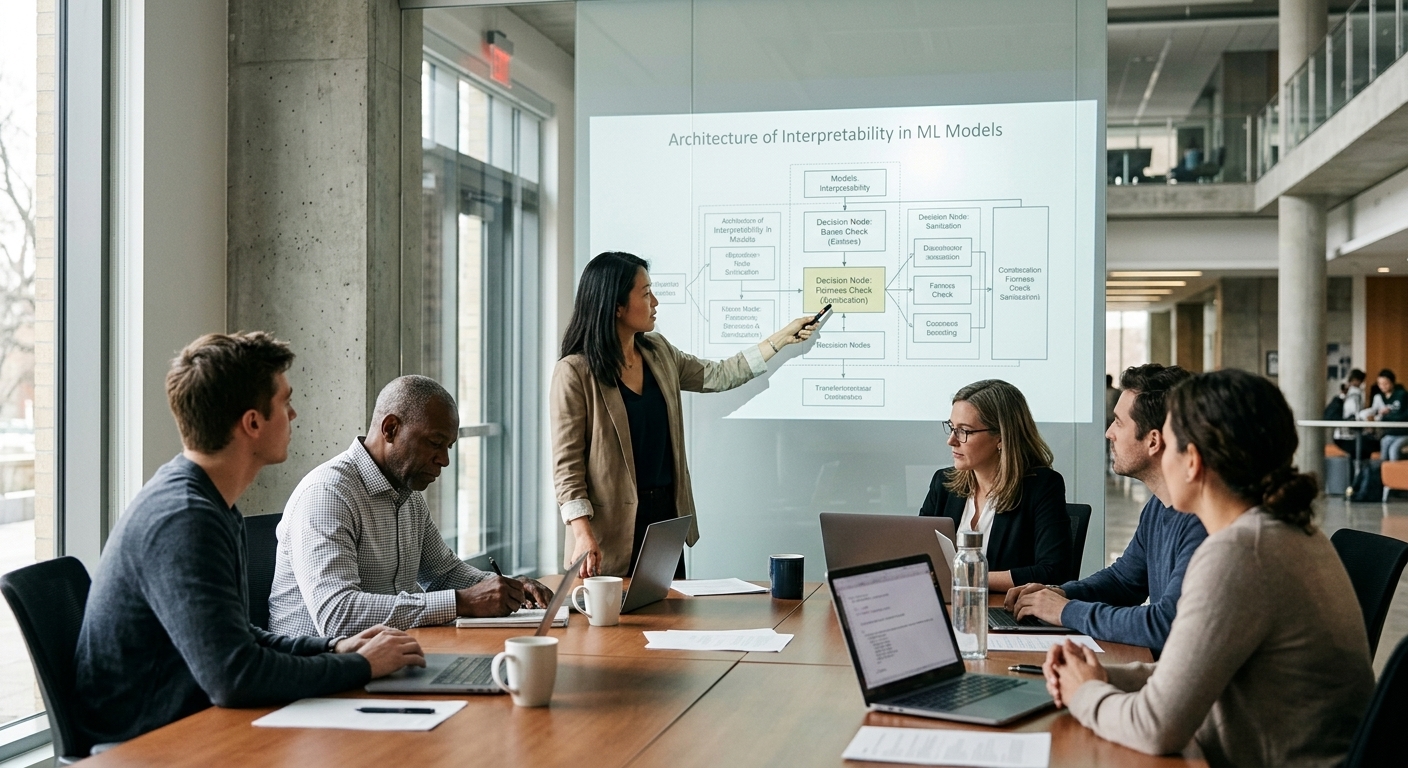
Η καινοτομία της συγκεκριμένης έρευνας έγκειται στη χρήση τεχνικών ερμηνευσιμότητας (interpretability) για την αποσφαλμάτωση των πολιτικών ασφαλείας. Αντί να ρωτάμε απλώς «είναι αυτό το κείμενο τοξικό;», το σύστημα καλείται να εξηγήσει *γιατί* θεωρεί ότι παραβιάζει μια συγκεκριμένη πολιτική. Χρησιμοποιώντας μεθόδους όπως οι χάρτες σημαντικότητας (saliency maps) και οι παραγόμενες από το μοντέλο αιτιολογήσεις σε φυσική γλώσσα, οι ερευνητές μπορούν να εντοπίσουν αν μια διαφωνία οφείλεται σε κακή διατύπωση της οδηγίας ή σε πραγματική ασάφεια του κειμένου.
- Εντοπισμός Ασαφών Κανόνων: Αν πολλοί σχολιαστές εστιάζουν σε διαφορετικές λέξεις-κλειδιά για να δικαιολογήσουν την ίδια απόφαση, η πολιτική ασφαλείας είναι πιθανότατα κακοδιατυπωμένη.
- Αποκάλυψη Προκαταλήψεων: Η ερμηνευσιμότητα επιτρέπει στους ερευνητές να δουν αν το μοντέλο (ή ο άνθρωπος) τιμωρεί συγκεκριμένες διαλέκτους ή κοινωνικές ομάδες ασυνείδητα.
- Βελτίωση του RLHF: Η Μάθηση με Ενίσχυση από Ανθρώπινη Ανάδραση (RLHF) γίνεται πολύ πιο αποτελεσματική όταν η ανάδραση συνοδεύεται από μια λογική εξήγηση, επιτρέποντας στο μοντέλο να «κατανοήσει» το πνεύμα του νόμου και όχι μόνο το γράμμα.
Προς μια Διαφανή Ηθική της Τεχνητής Νοημοσύνης
Η σημασία αυτής της προσέγγισης υπερβαίνει τα στενά όρια των εργαστηρίων πληροφορικής. Καθώς η ΕΕ και άλλοι διεθνείς οργανισμοί προχωρούν στη θέσπιση κανόνων για την Τεχνητή Νοημοσύνη (όπως το AI Act), η ανάγκη για εξηγήσιμες αποφάσεις ασφαλείας γίνεται επιτακτική. Δεν αρκεί πλέον για μια εταιρεία να ισχυρίζεται ότι το μοντέλο της είναι «ασφαλές»· πρέπει να είναι σε θέση να αποδείξει τη λογική πίσω από τα φίλτρα του.
«Η ασφάλεια στην Τεχνητή Νοημοσύνη δεν είναι ένας στατικός προορισμός, αλλά μια διαρκής διαπραγμάτευση μεταξύ των ανθρώπινων αξιών και των αλγοριθμικών περιορισμών.»
Συμπερασματικά, η μελέτη «Understanding Annotator Safety Policy with Interpretability» μας υπενθυμίζει ότι η ποιότητα της Τεχνητής Νοημοσύνης μας εξαρτάται άμεσα από την ποιότητα της ανθρώπινης καθοδήγησης. Μετατρέποντας την ερμηνευσιμότητα από ένα ακαδημαϊκό εργαλείο σε μια πρακτική μέθοδο ελέγχου των πολιτικών ασφαλείας, μπορούμε να ελπίζουμε σε συστήματα που δεν είναι μόνο πιο ασφαλή, αλλά και πιο δίκαια και διαφανή για όλους τους χρήστες, ανεξάρτητα από το πολιτισμικό τους υπόβαθρο.