Στον ταχέως εξελισσόμενο κόσμο της Τεχνητής Νοημοσύνης, η διαδικασία της «μετα-εκπαίδευσης» (post-training) —που περιλαμβάνει την επιβλεπόμενη μικρορύθμιση (SFT) και την ενισχυτική μάθηση (RL)— θεωρείται συχνά ως το στάδιο όπου το μοντέλο αποκτά τους «τρόπους» του και εξειδικεύεται. Ωστόσο, μια πρωτοποριακή μελέτη που δημοσιεύθηκε στο ArXiv (2605.08368) προτείνει μια ριζική επανεκτίμηση αυτής της διαδικασίας. Οι ερευνητές υποστηρίζουν ότι η διάκριση μεταξύ της SFT ως «μίμησης» και της RL ως «ανακάλυψης» είναι υπερβολικά απλοϊκή. Αντ' αυτού, εισάγουν ένα πλαίσιο βασισμένο στην Αρχή της Ελεύθερης Ενέργειας (Free Energy Principle) για να απαντήσουν στο θεμελιώδες ερώτημα: Δημιουργούμε νέες ικανότητες ή απλώς ξεκλειδώνουμε αυτές που ήδη υπάρχουν στα βάθη των δισεκατομμυρίων παραμέτρων του μοντέλου;
Η Ψευδαίσθηση της Μάθησης και το Ενεργειακό Φράγμα
Η παραδοσιακή αντίληψη θέλει τα Μεγάλα Γλωσσικά Μοντέλα (LLMs) να μαθαίνουν τον κόσμο κατά την προ-εκπαίδευση (pre-training) και να μαθαίνουν να επικοινωνούν κατά τη μετα-εκπαίδευση. Η νέα έρευνα υποδεικνύει ότι αυτό που συχνά εκλαμβάνουμε ως «μάθηση νέων δεξιοτήτων» είναι στην πραγματικότητα η μείωση του «ενεργειακού κόστους» πρόσβασης σε πληροφορίες που το μοντέλο κατέχει ήδη. Χρησιμοποιώντας εργαλεία από τη στατιστική φυσική και τη θεωρία της πληροφορίας, οι ερευνητές δείχνουν ότι η μετα-εκπαίδευση λειτουργεί λιγότερο ως δάσκαλος και περισσότερο ως γλύπτης.
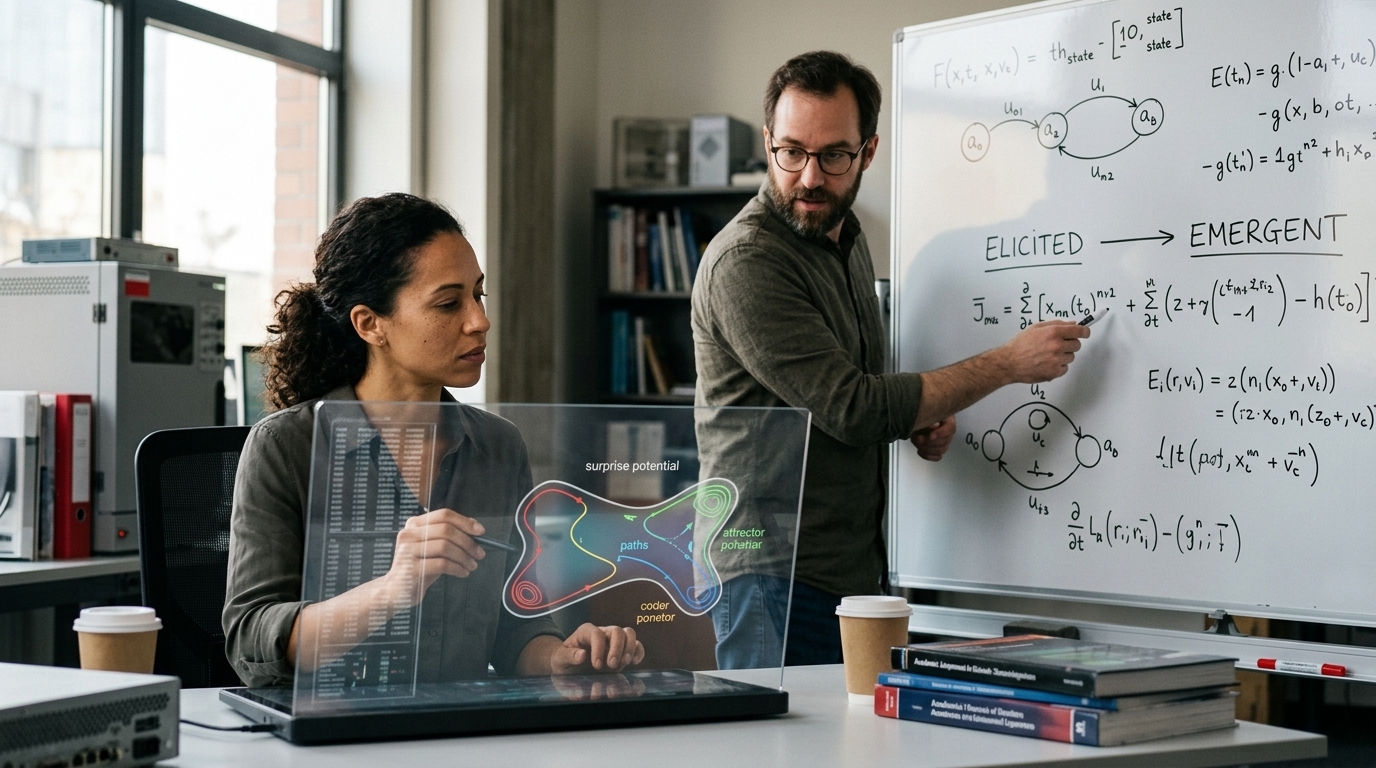
Όταν ένα μοντέλο υποβάλλεται σε Reinforcement Learning (RL), δεν ανακαλύπτει απαραίτητα νέες λογικές δομές. Αντίθετα, η διαδικασία αυτή αναδιαμορφώνει την κατανομή πιθανοτήτων του, καθιστώντας ορισμένες «λανθάνουσες» ικανότητες πιο προσιτές. Η μελέτη ονομάζει αυτή τη διαδικασία «Capability Elicitation» (Ανάδυση Ικανοτήτων). Η πραγματική «Capability Creation» (Δημιουργία Ικανοτήτων), από την άλλη πλευρά, απαιτεί μια πολύ πιο βίαιη μετατόπιση των παραμέτρων, η οποία σπάνια συμβαίνει στα στάδια της μικρορύθμισης.
Η Αρχή της Ελεύθερης Ενέργειας ως Πυξίδα
Η χρήση της Ελεύθερης Ενέργειας, μιας έννοιας που έγινε ευρέως γνωστή από τον νευροεπιστήμονα Karl Friston, προσφέρει ένα αυστηρό μαθηματικό πλαίσιο για την κατανόηση της συμπεριφοράς των μοντέλων. Σύμφωνα με το άρθρο, ένα LLM προσπαθεί να ελαχιστοποιήσει την «έκπληξη» (variational free energy) σε σχέση με τα δεδομένα εκπαίδευσης. Η μετα-εκπαίδευση δεν είναι τίποτα άλλο από μια προσπάθεια ευθυγράμμισης της εσωτερικής «ενέργειας» του μοντέλου με τις προσδοκίες των χρηστών.
- Ανάδυση (Elicitation): Το μοντέλο χρησιμοποιεί υπάρχοντα μοτίβα από την προ-εκπαίδευση για να ικανοποιήσει το νέο στόχο.
- Δημιουργία (Creation): Το μοντέλο αναγκάζεται να αναπτύξει εντελώς νέα κυκλώματα (circuits) για να επεξεργαστεί πληροφορίες που δεν υπήρχαν στην αρχική του βάση.
Αυτή η διάκριση έχει τεράστιες σημασίες για την ασφάλεια της Τεχνητής Νοημοσύνης. Αν μια επικίνδυνη ικανότητα μπορεί να «αναδυθεί» με ελάχιστη προσπάθεια, σημαίνει ότι η απειλή προϋπήρχε, κρυμμένη στις σκιές του νευρωνικού δικτύου, και δεν δημιουργήθηκε από την κακή χρήση της μικρορύθμισης.
Οι Επιπτώσεις στην Ευθυγράμμιση και την Αξιολόγηση
Ένα από τα πιο προκλητικά συμπεράσματα της έρευνας είναι ότι τα τρέχοντα benchmarks (τεστ αξιολόγησης) αποτυγχάνουν να διακρίνουν μεταξύ των δύο φαινομένων. Συχνά πανηγυρίζουμε για την «ευφυΐα» ενός μοντέλου που απλώς έμαθε να ανακαλεί καλύτερα τις γνώσεις του, ενώ αγνοούμε τη στασιμότητα στην πραγματική δημιουργία νέων γνωστικών οδών. Η ανάλυση των ερευνητών δείχνει ότι η RL είναι εξαιρετικά αποτελεσματική στην ανάδυση, αλλά εκπληκτικά αναποτελεσματική στη δημιουργία, κάτι που εξηγεί γιατί τα μοντέλα συχνά «καταρρέουν» ή παρουσιάζουν παραισθήσεις όταν πιέζονται πέρα από τα όρια της προ-εκπαίδευσής τους.
«Η μετα-εκπαίδευση δεν είναι η γέννηση της νοημοσύνης, αλλά η χαλιναγώγηση ενός ήδη υπάρχοντος χάους πληροφοριών», σημειώνουν οι συγγραφείς.
Για την ελληνική ερευνητική κοινότητα και τις επιχειρήσεις που δραστηριοποιούνται στην προσαρμογή μοντέλων, το μήνυμα είναι σαφές: η ποιότητα της προ-εκπαίδευσης παραμένει ο απόλυτος περιοριστικός παράγοντας. Κανένα ποσό RLHF δεν μπορεί να δημιουργήσει ικανότητες που δεν έχουν «φυτευτεί» ως σπόροι κατά την αρχική επεξεργασία των τρισεκατομμυρίων tokens.
Συμπεράσματα για το Μέλλον
Καθώς οδεύουμε προς το 2027, η κατανόηση της εσωτερικής δυναμικής των LLMs μέσω της φυσικής και της θερμοδυναμικής θα γίνει το νέο πρότυπο. Η μελέτη αυτή ανοίγει το δρόμο για πιο αποδοτικές μεθόδους εκπαίδευσης, όπου θα γνωρίζουμε εκ των προτέρων αν ένα μοντέλο *μπορεί* να μάθει μια εργασία ή αν απλώς χάνουμε χρόνο προσπαθώντας να εκμαιεύσουμε κάτι που δεν υπάρχει. Η διάκριση μεταξύ ανάδυσης και δημιουργίας δεν είναι απλώς ακαδημαϊκή· είναι ο οδικός χάρτης για την επόμενη γενιά τεχνητής γενικής νοημοσύνης (AGI).