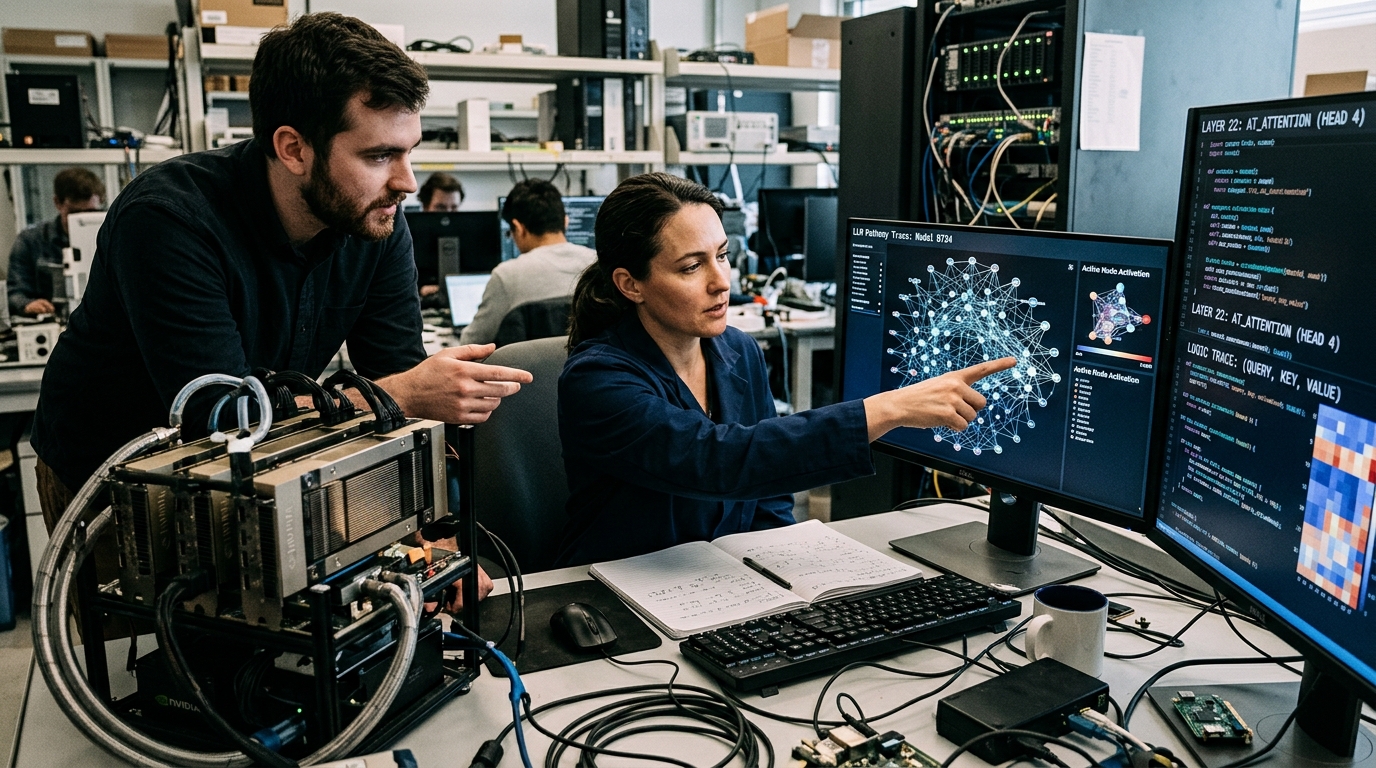
Η ραγδαία άνοδος των Μεγάλων Γλωσσικών Μοντέλων (LLMs), όπως το GPT-4 και το Claude, έχει φέρει την ανθρωπότητα μπροστά σε ένα παράδοξο που θυμίζει επιστημονική φαντασία: δημιουργήσαμε συστήματα που επιδεικνύουν εκπληκτικές ικανότητες επίλυσης προβλημάτων, αλλά δεν είμαστε σίγουροι για το πώς ακριβώς φτάνουν στις απαντήσεις τους. Το πρόσφατο άρθρο στο Communications of the ACM θέτει το κρίσιμο ερώτημα: Μπορούμε πράγματι να κατανοήσουμε αν αυτά τα μοντέλα «σκέφτονται» ή αν απλώς αναπαράγουν μοτίβα με έναν εξαιρετικά πειστικό τρόπο;
Η Ψευδαίσθηση της Λογικής έναντι της Πραγματικής Συλλογιστικής
Το κεντρικό ζήτημα που απασχολεί την κοινότητα της τεχνητής νοημοσύνης είναι η διάκριση μεταξύ της στατιστικής πρόβλεψης και της αιτιακής συλλογιστικής. Τα LLMs εκπαιδεύονται να προβλέπουν την επόμενη λέξη (token) σε μια ακολουθία. Αυτή η διαδικασία, αν και απλή στη σύλληψή της, οδηγεί σε «αναδυόμενες ικανότητες» (emergent abilities) όταν η κλίμακα των δεδομένων και των παραμέτρων γίνει αρκούντως μεγάλη. Ωστόσο, πολλοί ερευνητές, όπως ο Emily Bender, υποστηρίζουν ότι τα μοντέλα αυτά παραμένουν «στοχαστικοί παπαγάλοι» (stochastic parrots), ικανοί να συνθέτουν κείμενο χωρίς να κατανοούν το νόημα ή τους φυσικούς νόμους που διέπουν τον κόσμο.
Από την άλλη πλευρά, υπάρχουν ενδείξεις ότι τα μοντέλα αναπτύσσουν εσωτερικές αναπαραστάσεις του κόσμου, τα λεγόμενα «παγκόσμια μοντέλα» (world models). Για παράδειγμα, όταν ένα LLM καλείται να παίξει σκάκι μέσω κειμένου, φαίνεται να διατηρεί μια εσωτερική κατάσταση της σκακιέρας, παρόλο που δεν έχει δει ποτέ φυσική σκακιέρα. Αυτό υποδηλώνει ότι η «συλλογιστική» τους μπορεί να μην είναι απλή απομνημόνευση, αλλά μια μορφή υπολογιστικής προσομοίωσης κανόνων.
Το Πρόβλημα της Ερμηνευσιμότητας: Μέσα στο Μαύρο Κουτί
Η προσπάθεια να κατανοήσουμε πώς σκέφτονται τα LLMs ονομάζεται «μηχανιστική ερμηνευσιμότητα» (mechanistic interpretability). Είναι η προσπάθεια των επιστημόνων να αντιστρέψουν τη μηχανική των νευρωνικών δικτύων, χαρτογραφώντας ποιοι «νευρώνες» ενεργοποιούνται για συγκεκριμένες έννοιες. Το πρόβλημα είναι ότι ένα μοντέλο με τρισεκατομμύρια παραμέτρους είναι υπερβολικά περίπλοκο για την ανθρώπινη νόηση. Οι ερευνητές βρίσκονται σε μια κατάσταση παρόμοια με τους πρώτους νευροεπιστήμονες που προσπαθούσαν να καταλάβουν τον ανθρώπινο εγκέφαλο παρατηρώντας απλώς τη ροή του αίματος.
- Ανάλυση Χαρακτηριστικών: Πρόσφατες μελέτες από την Anthropic έδειξαν ότι μπορούμε να απομονώσουμε «χαρακτηριστικά» (features) που αντιστοιχούν σε έννοιες όπως η «διαφθορά» ή η «γεωμετρία».
- Chain-of-Thought (CoT): Η τεχνική που αναγκάζει το μοντέλο να εξηγεί τα βήματά του βοηθά στη βελτίωση της λογικής, αλλά δεν εγγυάται ότι η εξήγηση αντικατοπτρίζει την πραγματική εσωτερική διαδικασία.
- Πρόβλημα Πίστης (Faithfulness): Συχνά, το μοντέλο δίνει μια λογική εξήγηση για μια λάθος απάντηση, κάτι που ονομάζεται «εκ των υστέρων ορθολογικοποίηση».
Μόλυνση Δεδομένων και η Παγίδα των Benchmarks
Ένας από τους μεγαλύτερους κινδύνους στην αξιολόγηση της συλλογιστικής των LLMs είναι η «μόλυνση των δεδομένων» (data contamination). Επειδή αυτά τα μοντέλα εκπαιδεύονται σχεδόν σε όλο το δημόσιο διαδίκτυο, είναι πολύ πιθανό να έχουν ήδη «δει» τις λύσεις στα τεστ λογικής και μαθηματικών που χρησιμοποιούμε για να τα αξιολογήσουμε. Έτσι, αυτό που φαίνεται ως ευφυής συλλογιστική μπορεί στην πραγματικότητα να είναι απλή ανάκτηση πληροφοριών από τη μνήμη τους.
«Η ικανότητα ενός μοντέλου να λύνει ένα πρόβλημα δεν συνεπάγεται απαραίτητα ότι κατέχει τη λογική δομή του προβλήματος. Μπορεί απλώς να αναγνωρίζει το στατιστικό αποτύπωμα της λύσης.»
Για να αντιμετωπιστεί αυτό, οι ερευνητές αναπτύσσουν δυναμικά benchmarks, όπου τα προβλήματα δημιουργούνται σε πραγματικό χρόνο και δεν υπάρχουν στο σύνολο εκπαίδευσης. Μόνο τότε μπορούμε να είμαστε σίγουροι ότι το μοντέλο εφαρμόζει γενικευμένη λογική και όχι απομνημόνευση.
Το Μέλλον: Προς μια Υβριδική Νοημοσύνη
Η κατανόηση της συλλογιστικής των LLMs δεν είναι μόνο ακαδημαϊκό ζήτημα· είναι ζήτημα ασφάλειας. Αν δεν ξέρουμε πώς σκέφτεται ένα σύστημα, δεν μπορούμε να προβλέψουμε πότε θα αποτύχει ή πώς θα συμπεριφερθεί σε κρίσιμες καταστάσεις, όπως στην ιατρική ή τη διακυβέρνηση. Η τάση δείχνει προς τη δημιουργία νευρο-συμβολικών συστημάτων (neuro-symbolic AI), τα οποία συνδυάζουν τη στατιστική δύναμη των LLMs με τη σκληρή, διαφανή λογική των παραδοσιακών υπολογιστικών συστημάτων. Μόνο έτσι θα μπορέσουμε να γεφυρώσουμε το χάσμα μεταξύ της «διαίσθησης» της AI και της επαληθεύσιμης λογικής.