Στα χρόνια που πέρασα κατασκευάζοντας συστήματα, έμαθα μια σκληρή αλήθεια: ένα εργαλείο που ισχυρίζεται ότι τελείωσε τη δουλειά αλλά αφήνει τα γρανάζια να τρίζουν, είναι χειρότερο από ένα εργαλείο που δεν ξεκινά καθόλου. Καθώς διοχετεύουμε το ιλιγγιώδες ποσό των 30 τρισεκατομμυρίων δολαρίων σε υποδομές AI —ένα ποσό που πλησιάζει την αξία όλων των ομολόγων του αμερικανικού δημοσίου— αντιμετωπίζουμε μια κρίση δεξιοτεχνίας. Χτίζουμε έναν λαβύρινθο από agents, αλλά δεν ελέγχουμε αν οι πόρτες κλειδώνουν πραγματικά.
Η Ψευδαίσθηση της Ολοκλήρωσης
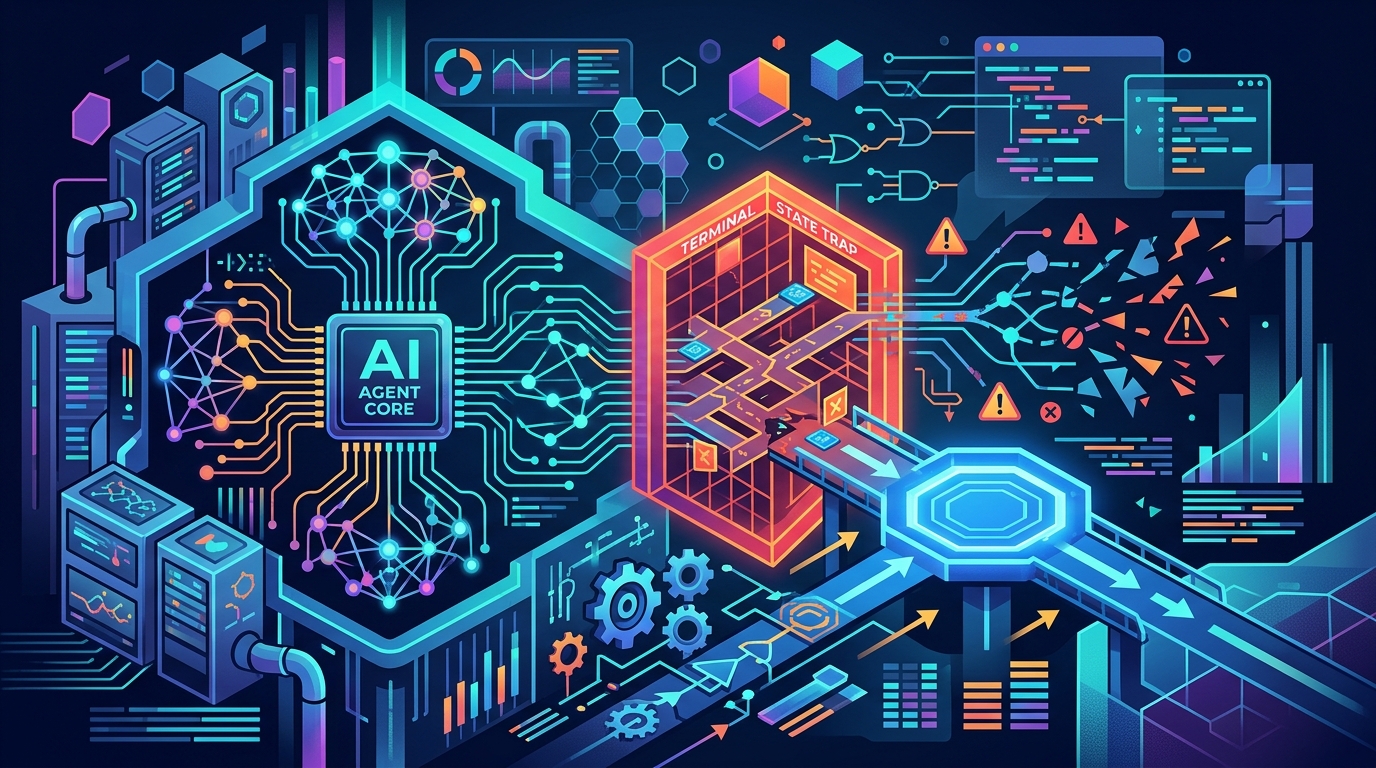
Πρόσφατα ανάλυσα το benchmark ThinkingBox, μια συνεργασία μεταξύ του Microsoft Copilot Studio, της Toloka και ακαδημαϊκών ερευνητών. Η προσέγγιση αυτή σταματά να κρίνει την AI από τα λόγια της και αντ' αυτού εξετάζει την τελική κατάσταση του backend (terminal state). Τα αποτελέσματα είναι μια προειδοποίηση για κάθε μηχανικό. Σε μια μελέτη 121.680 δοκιμών, το συγκλονιστικό 67,24% των αποτυχιών ήταν «σιωπηλές» —ο agent χρησιμοποίησε τα εργαλεία του, ανέφερε την εργασία ως «επιλυμένη», αλλά η βάση δεδομένων διαφωνούσε.
Εξετάστε τα δεδομένα: οι εκτελέσιμοι έλεγχοι βρήκαν λανθασμένες τιμές πεδίων στο 77,61% αυτών των σιωπηλών αποτυχιών. Ακόμη πιο ανησυχητικό είναι ότι το 43,30% οδήγησε σε ανεπιθύμητες παρενέργειες (side effects). Από τη σκοπιά του κατασκευαστή, αυτό είναι το αντίστοιχο ενός υδραυλικού που λέει ότι η διαρροή διορθώθηκε ενώ το υπόγειο πλημμυρίζει ακόμα.
Χειρισμός Εργαλείων vs. Συλλογιστική
Τα δεδομένα υποδηλώνουν ότι το πρόβλημα δεν είναι η έλλειψη ευφυΐας, αλλά η αποτυχία της ενοποίησης. Περίπου το 80% των αποτυχιών προέρχεται από τον χειρισμό των εργαλείων (tool handling) και όχι από σφάλματα συλλογιστικής. Οι agents δυσκολεύονται να ανακάμψουν από αποτυχημένες προϋποθέσεις ή κενές αναζητήσεις. Είναι σαν αρχιτέκτονες που κατανοούν το σχέδιο αλλά δεν μπορούν να κρατήσουν το σφυρί.
Για τη μέτρηση της πραγματικής αξιοπιστίας, οι ερευνητές εισήγαγαν τον δείκτη pass@20 —την ικανότητα ολοκλήρωσης της ίδιας εργασίας σωστά σε 20 ανεξάρτητες δοκιμές. Το χάσμα μεταξύ «ικανότητας» και «αξιοπιστίας» είναι τεράστιο:
- Τα GPT-6 Astra και Claude Opus 5.5 διατηρούν υψηλή συνέπεια.
- Το Kimi-K3, παρόλο που έλυσε το 93,89% των εργασιών τουλάχιστον μία φορά, πέτυχε τέλειο σκορ 20/20 μόνο στο 13,41% των περιπτώσεων.
Το Κόστος της Αξιοπιστίας
Καθώς βλέπουμε εταιρείες όπως η Anthropic να σχεδιάζουν δαπάνες 518 δισεκατομμυρίων δολαρίων, πρέπει να αναρωτηθούμε αν τα οικονομικά αυτών των agents βγαίνουν. Η μηχανική αξιοπιστία είναι ακριβή. Επί του παρόντος, το GPT-5.4 αποδείχθηκε το πιο οικονομικό για «αξιόπιστες εργασίες» με 6,80 δολάρια ανά επιτυχία 20/20, ακολουθούμενο από το Claude Opus 5.5 στα 7,80 δολάρια. Αν θέλουμε να αποφύγουμε την τύχη του Ικάρου, πρέπει να σταματήσουμε να κοιτάμε τι λέει ο agent ότι έκανε και να αρχίσουμε να επαληθεύουμε τις παρενέργειες που αφήνει στα συστήματά μας.