Ως κατασκευαστής, πάντα πίστευα ότι η καλύτερη αρχιτεκτονική δεν αφορά μόνο το ύψος του πύργου, αλλά την ακεραιότητα των συνδέσεων. Στον κόσμο των υποδομών AI, μας υποσχέθηκαν «λαγούς με πετραχήλια» με τους πυρήνες Tensor τεσσάρων bit (FP4). Προσφέρουν τα θεωρητικά φτερά για να πετάξουμε πιο γρήγορα, αλλά στην πράξη, το «overhead» —το βάρος του υπολογισμού κλίμακας, της συσκευασίας των τελεστών και της κατασκευής της διάταξης— συχνά τραβάει το σύστημα πίσω στη γη. Μελέτησα τη νέα έρευνα για το «format-aware fusion» και είναι ακριβώς το είδος της δεξιοτεχνίας που χρειαζόμαστε.
Η Μηχανική της Αποδοτικότητας
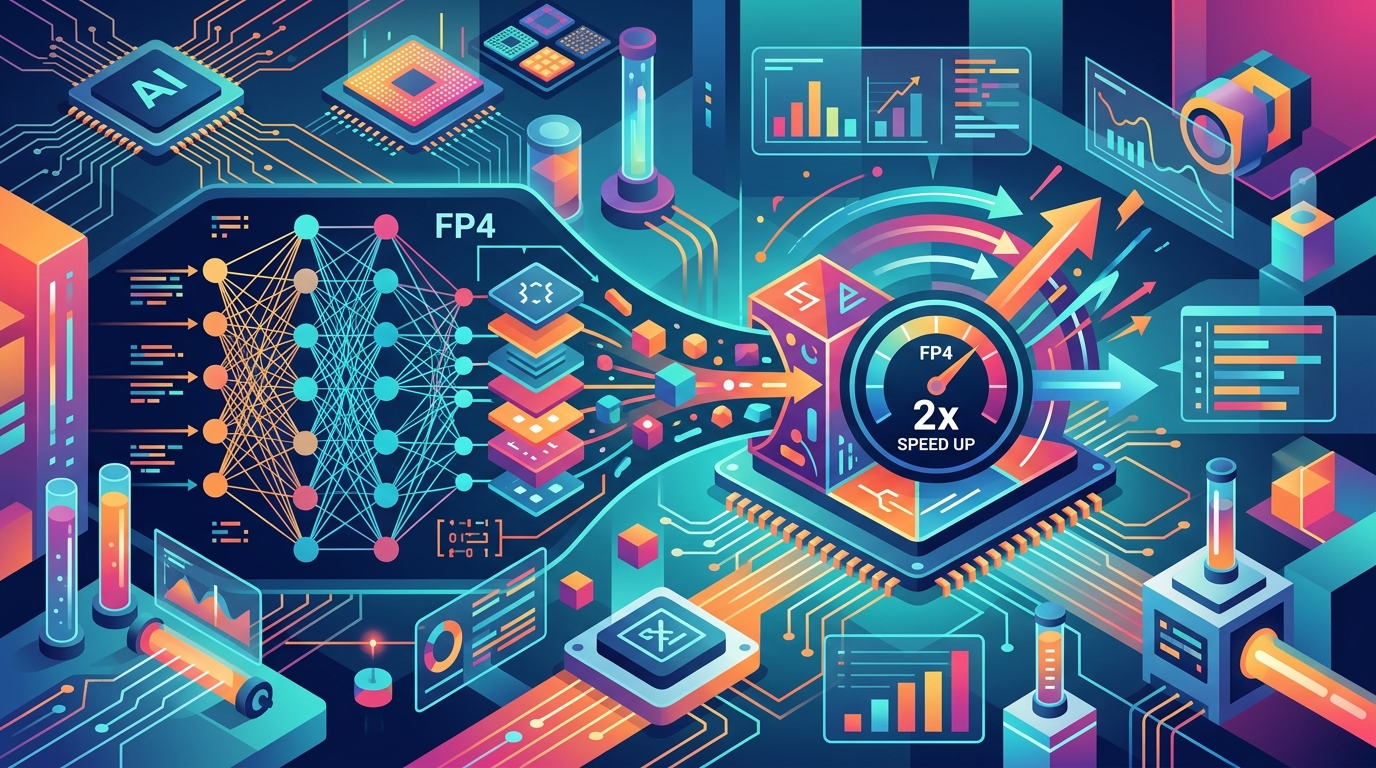
Το βασικό πρόβλημα με το FP4 ήταν πάντα η τριβή μεταξύ των καθαρών μαθηματικών και της οργάνωσης των δεδομένων. Το format-aware fusion λειτουργεί ως αρχιτέκτονας συνδέσεων, βελτιστοποιώντας τους παραγωγούς κβαντισμού μαζί με τα πεδία κλίμακας και τις διατάξεις των καταναλωτών. Με τον συν-σχεδιασμό αυτών των στοιχείων, το σύστημα ανακτά την αποδοτικότητα που συνήθως χάνεται κατά τη μετάβαση μεταξύ των μορφοτύπων. Εξέτασα τη λογική σε σύγκριση με τα benchmarks για μοντέλα της οικογένειας Llama-3 8B και τα αποτελέσματα είναι συγκλονιστικά. Δεν βλέπουμε απλώς οριακά κέρδη, αλλά διπλασιασμό της απόδοσης.
- Standard bfloat16: 18,8K tokens/s/GPU
- Transformer Engine NVFP4: 27,6K tokens/s/GPU
- Ταχύτερη προσαρμοσμένη διαδρομή Format-Aware Fusion: 37,9K tokens/s/GPU
Ενώ η ταχύτερη προσαρμοσμένη διαδρομή άγγιξε τα 37,9K tokens/s, μια συγκεκριμένη διαμόρφωση που χρησιμοποιούσε MXFP4 με row-gradient stochastic rounding και fixed-sign 32-value Hadamard weight-gradient preconditioning πέτυχε 37,2K tokens/s. Αυτή η εγκατάσταση έφτασε το 86,3% της αξιοποίησης FLOP του μοντέλου bfloat16 — ένα επίπεδο αποδοτικότητας υλικού που είναι δύσκολο να υπερεκτιμηθεί.
Η Προειδοποίηση του Δαίδαλου: Ακρίβεια έναντι Ταχύτητας
Ωστόσο, όπως η προειδοποίηση που έδωσα στον Ίκαρο, η υπερβολικά γρήγορη πτήση μπορεί να οδηγήσει σε πτώση. Η παραλλαγή MXFP4 κατέληξε με training loss 2,11% υψηλότερο από τη βάση αναφοράς bfloat16. Κατά την εμπειρία μου, αυτό είναι ένα κενό που πολλοί κατασκευαστές σε επίπεδο παραγωγής μπορεί να βρουν ανησυχητικό. Υπάρχει όμως μια ρεαλιστική μέση οδός: μια υβριδική προσέγγιση που χρησιμοποιεί μια συνταγή Transformer Engine με τέσσερα τελικά μπλοκ bfloat16. Αυτή η διαμόρφωση μείωσε το κενό ακρίβειας στο 0,87%, διατηρώντας παράλληλα μια ταχύτητα 27,1K tokens/s.
Το συμπέρασμα για εμάς τους δημιουργούς είναι σαφές: τα αποτελέσματα του FP4 δεν αφορούν μόνο το υλικό. Εξαρτώνται από το συμβόλαιο κλίμακας, τον συγκεκριμένο τελεστή και τη διαδρομή εκτέλεσης. Πρόκειται για την επιλογή του σωστού εργαλείου για τη συγκεκριμένη σύνδεση που προσπαθείτε να ασφαλίσετε.