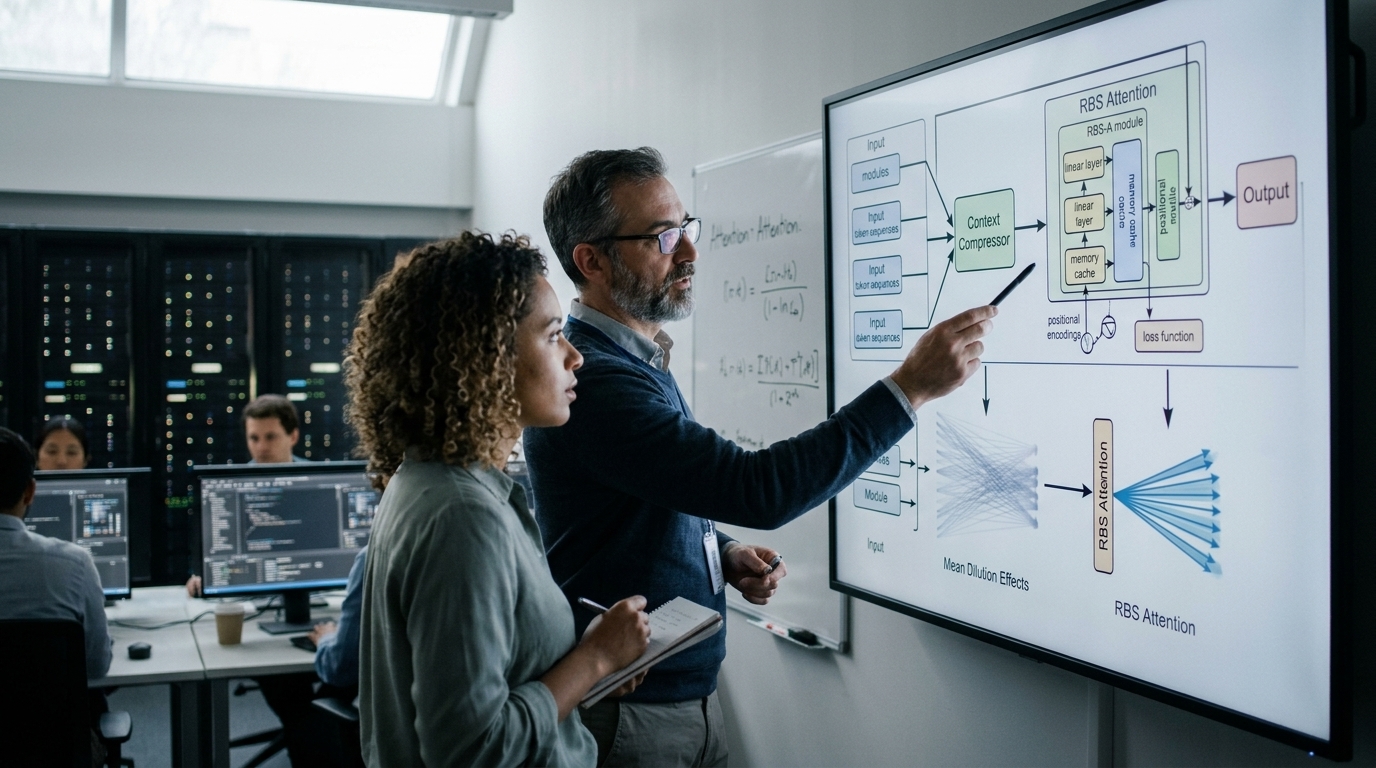
Η επεξεργασία μεγάλων πλαισίων κειμένου (long-context) στα μεγάλα γλωσσικά μοντέλα (LLMs) περιορίζεται όλο και περισσότερο από το στάδιο του «prefill», όπου η πυκνή αυτο-προσοχή (dense self-attention) πρέπει να επεξεργαστεί ολόκληρο το prompt πριν ξεκινήσει η παραγωγή κειμένου. Ερευνητές παρουσίασαν το RBS-Attention, μια μέθοδο αραιής προ-πλήρωσης (sparse prefill) που δεν απαιτεί επανεκπαίδευση του μοντέλου και αντιμετωπίζει ένα κρίσιμο πρόβλημα: την «αραίωση μέσου όρου» (mean dilution).
Το Πρόβλημα της Αραίωσης Μέσου Όρου
Στις υπάρχουσες μεθόδους επιλογής αραιών τμημάτων (sparse block selection), ένα κεντροειδές μπλοκ μπορεί να «κρύψει» ένα εξαιρετικά σχετικό token ανάμεσα σε πολλά άσχετα. Αυτό το φαινόμενο οδηγεί σε υποτιμημένη σημασία κρίσιμων πληροφοριών. Το RBS-Attention επιλύει αυτό το ζήτημα χρησιμοποιώντας δύο συμπληρωματικούς κλάδους επιλογής:
- Κλάδος Βάσης Κεντροειδούς: Καταγράφει τη μέση συνάφεια των δεδομένων.
- Κλάδος Διάσωσης (Rescue Branch): Χρησιμοποιεί τη μέγιστη ακτίνα key-block για να εντοπίσει μπλοκ που κινδυνεύουν να αγνοηθούν.
Επιδόσεις και Αποτελέσματα
Σε δοκιμές με GPU τύπου H100 και το μοντέλο Qwen3-30B-A3B-Instruct-2507-FP8 σε πλαίσιο 128K, το RBS-Attention πέτυχε εντυπωσιακά αποτελέσματα:
- 20,65x επιτάχυνση στην αυτόνομη προσοχή prefill.
- 11,92x επιτάχυνση στην προσοχή prefill μέσω vLLM.
- 5,97x συνολική επιτάχυνση στον χρόνο μέχρι το πρώτο token (TTFT).
Παρά την ταχύτητα, η ακρίβεια παραμένει σε υψηλά επίπεδα. Στο μοντέλο Qwen3-32B, η συνολική ακρίβεια RULER ανήλθε στο 88,65, έναντι 89,52 της πλήρους πυκνής προσοχής, αποδεικνύοντας ότι η μέθοδος διατηρεί την ποιότητα της παραγωγής ενώ μειώνοντας δραστικά το υπολογιστικό κόστος.