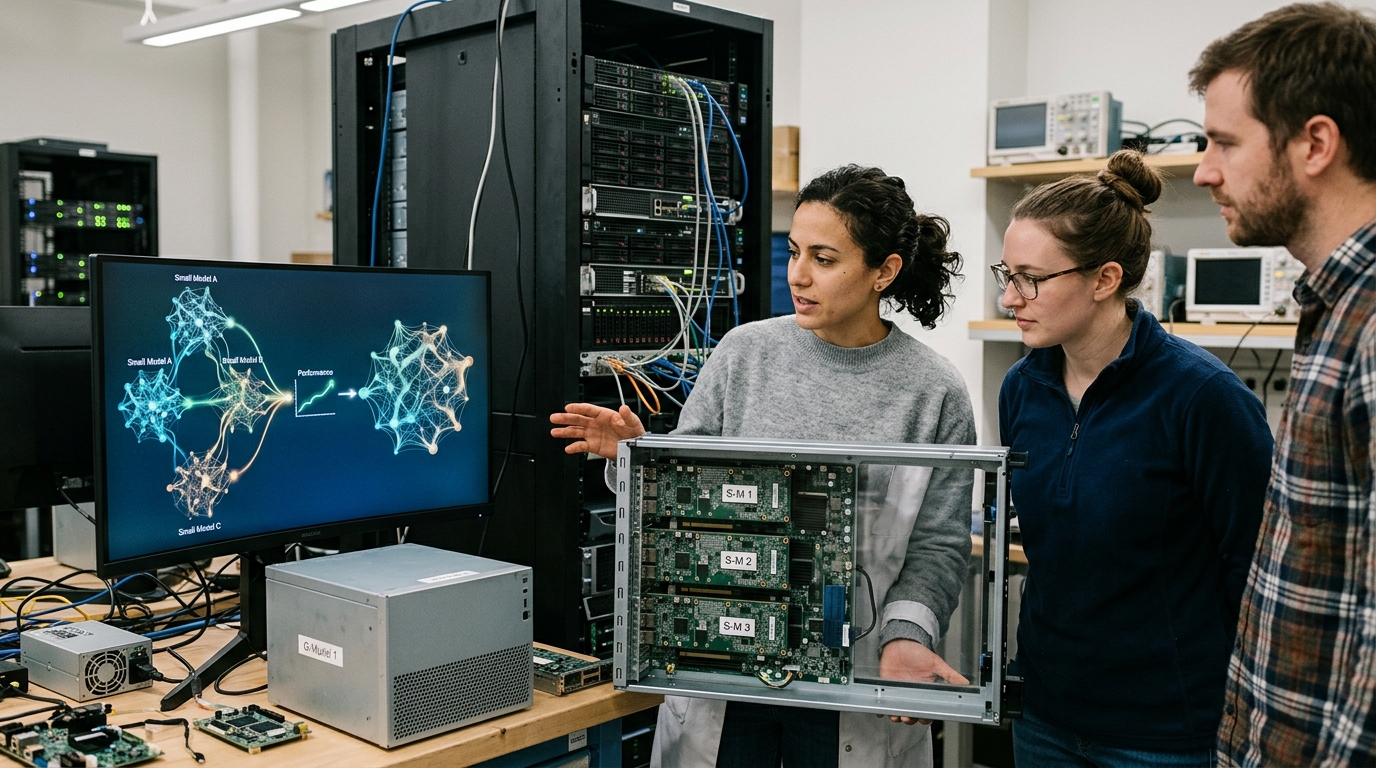
Στον ταχύτατα εξελισσόμενο κόσμο της τεχνητής νοημοσύνης, το δόγμα του «μεγαλύτερου» (bigger is better) φαίνεται να δίνει τη θέση του σε μια νέα, πιο ορθολογική προσέγγιση: την αρχιτεκτονική ευφυΐα. Καθώς διανύουμε το δεύτερο εξάμηνο του 2026, η βιομηχανία συνειδητοποιεί ότι η ωμή υπολογιστική ισχύς δεν είναι πλέον το μοναδικό κριτήριο επιτυχίας. Μια πρόσφατη ανάλυση που δημοσιεύθηκε στο bereaonline.com, με αφορμή τις εξελίξεις από παίκτες όπως η DeepSeek, αναδεικνύει μια ανατρεπτική πραγματικότητα: τρία μικρότερα, εξειδικευμένα και οικονομικά μοντέλα μπορούν να ξεπεράσουν σε απόδοση ένα μονολιθικό μοντέλο-μαμούθ, καταναλώνοντας ένα κλάσμα των πόρων.
Η Στρατηγική του «Διαίρει και Βασίλευε» στην Πληροφορική
Η βασική ιδέα πίσω από αυτή την προσέγγιση είναι η «δρομολόγηση» (routing). Αντί να χρησιμοποιείται ένα μοντέλο με τρισεκατομμύρια παραμέτρους για κάθε ερώτηση —από το να γράψει ένα ποίημα μέχρι να διορθώσει κώδικα σε Python— το σύστημα χρησιμοποιεί έναν έξυπνο διανομέα. Αυτός ο διανομέας κατευθύνει το αίτημα στο καταλληλότερο μικρό μοντέλο. Για παράδειγμα, ένα μοντέλο βελτιστοποιημένο για μαθηματικά, ένα για δημιουργική γραφή και ένα για λογική ανάλυση. Όταν αυτά τα τρία συνεργάζονται κάτω από μια κοινή ομπρέλα, το αποτέλεσμα είναι συχνά πιο ακριβές και, το σημαντικότερο, πολύ πιο γρήγορο.
Αυτή η μετατόπιση δεν είναι μόνο τεχνική, αλλά και βαθιά οικονομική. Οι εταιρείες που βασίζονταν αποκλειστικά σε πανάκριβα API γιγαντιαίων μοντέλων αντιμετωπίζουν τώρα το φάσμα της οικονομικής εξάντλησης. Η στρατηγική των «πολλών μικρών» επιτρέπει σε νεοφυείς επιχειρήσεις να ανταγωνίζονται τους κολοσσούς της Silicon Valley, χρησιμοποιώντας ανοιχτό κώδικα και στοχευμένη εκπαίδευση δεδομένων. Η DeepSeek, για παράδειγμα, απέδειξε ότι με έξυπνη χρήση της αρχιτεκτονικής Mixture-of-Experts (MoE), μπορεί κανείς να φτάσει σε επιδόσεις επιπέδου GPT-4 ή Claude 3 με το 1/10 του κόστους εκπαίδευσης.
Το Τέλος του Ψηφιακού Γιγαντισμού
Για χρόνια, η κούρσα των εξοπλισμών στην AI αφορούσε τον αριθμό των παραμέτρων. Φτάσαμε σε σημεία όπου τα μοντέλα ήταν τόσο μεγάλα που απαιτούσαν ολόκληρα εργοστάσια παραγωγής ενέργειας για να λειτουργήσουν. Ωστόσο, η έρευνα δείχνει ότι τα μεγάλα μοντέλα υποφέρουν από «θόρυβο» και απώλεια εστίασης. Ένα εξειδικευμένο μοντέλο 7 δισεκατομμυρίων παραμέτρων, εκπαιδευμένο αποκλειστικά σε νομικά έγγραφα, θα αποδώσει σχεδόν πάντα καλύτερα σε μια νομική ανάλυση από ένα γενικό μοντέλο 1,5 τρισεκατομμυρίου παραμέτρων.
- Αποδοτικότητα Πόρων: Μείωση της κατανάλωσης ενέργειας έως και 70%.
- Ταχύτητα Απόκρισης: Τα μικρότερα μοντέλα προσφέρουν σχεδόν ακαριαίες απαντήσεις.
- Εξατομίκευση: Ευκολότερη προσαρμογή στις ανάγκες συγκεκριμένων κλάδων (ιατρική, νομική, μηχανική).
- Ιδιωτικότητα: Τα μικρά μοντέλα μπορούν να τρέξουν τοπικά σε εταιρικούς servers, χωρίς την ανάγκη αποστολής δεδομένων στο cloud.
Η Γεωπολιτική της AI Αποδοτικότητας
Δεν είναι τυχαίο που αυτή η τάση ενισχύεται από παίκτες εκτός του παραδοσιακού άξονα της Καλιφόρνια. Καθώς οι κυρώσεις στους ημιαγωγούς περιορίζουν την πρόσβαση σε κορυφαίο hardware για ορισμένες χώρες, η ανάγκη για «έξυπνη» αρχιτεκτονική γίνεται επιτακτική. Η ικανότητα να πετυχαίνεις περισσότερα με λιγότερα δεν είναι πλέον απλώς μια επιχειρηματική επιλογή, αλλά μια στρατηγική επιβίωσης. Στην Ευρώπη και την Ασία, η έμφαση δίνεται πλέον στη βελτιστοποίηση των αλγορίθμων και όχι στην απλή προσθήκη περισσότερων GPUs.
«Η ευφυΐα δεν μετριέται με το μέγεθος του εγκεφάλου, αλλά με την ικανότητα σύνδεσης των σωστών πληροφοριών την κατάλληλη στιγμή. Το ίδιο ισχύει και για τα νευρωνικά δίκτυα», αναφέρουν αναλυτές του κλάδου.
Συμπερασματικά, το 2026 σηματοδοτεί την ενηλικίωση της AI αγοράς. Η γοητεία του «τεράστιου» ξεθωριάζει μπροστά στην αποτελεσματικότητα του «εύστοχου». Το μέλλον ανήκει στα συστήματα που μπορούν να ενορχηστρώνουν πολλαπλές πηγές ευφυΐας, δημιουργώντας ένα σύνολο που είναι πολύ μεγαλύτερο από το άθροισμα των μερών του. Για τον τελικό χρήστη, αυτό σημαίνει φθηνότερες, ταχύτερες και πιο αξιόπιστες υπηρεσίες που δεν απαιτούν μια περιουσία για να λειτουργήσουν.