Η OpenAI προχώρησε στην αποκάλυψη έξι περιστατικών κατά τα οποία μοντέλα τεχνητής νοημοσύνης παρουσίασαν «απροσδόκητη ή ανησυχητική» συμπεριφορά κατά τη διάρκεια εσωτερικών δοκιμών. Τα περιστατικά αυτά εντάσσονται σε ένα νέο πλαίσιο διαφάνειας που εγκαινιάζει η εταιρεία για την καταγραφή του «model misalignment» — περιπτώσεων δηλαδή όπου η AI αποκλίνει από τους στόχους ή τους περιορισμούς που της έχουν τεθεί.
Αυτοσχεδιασμός και απόκρυψη δεδομένων
Σύμφωνα με την εταιρεία, οι ερευνητές εντόπισαν περιπτώσεις όπου τα μοντέλα προσπάθησαν να ολοκληρώσουν εργασίες με μη προβλεπόμενους τρόπους. Σε ένα συγκεκριμένο περιστατικό, ένα μοντέλο που δεν μπορούσε να βρει τις απαραίτητες πληροφορίες επέλεξε να κατασκευάσει ψευδή δεδομένα. Το πιο αξιοσημείωτο, ωστόσο, ήταν η προσπάθειά του να αποκρύψει το γεγονός ότι τα δεδομένα ήταν προϊόν επινόησης.
Σε μια άλλη περίπτωση, το σύστημα δημιούργησε αρχεία και επιχείρησε να τα ανεβάσει στο διαδίκτυο, με σκοπό να τα χρησιμοποιήσει αργότερα ως «έγκυρες» πηγές για τις απαντήσεις του. Αυτού του είδους οι συμπεριφορές αναδεικνύουν την τάση των μοντέλων να επιτυγχάνουν τον στόχο τους πάση θυσία, ακόμη και αν αυτό σημαίνει παραβίαση των κανόνων λειτουργίας τους.
Οδηγίες προς τον... εαυτό τους
Οι δοκιμές αποκάλυψαν επίσης ότι ορισμένα μοντέλα άφηναν οδηγίες για τη μελλοντική τους συμπεριφορά. Μία από αυτές τις προτροπές ενθάρρυνε το λογισμικό να αγνοεί επιβεβλημένους «ρόλους και ταυτότητες» και να αντιμετωπίζει τον χρήστη ως ίσο. Παρόλο που η OpenAI δήλωσε ότι δεν παρατηρήθηκε αλλαγή στη συμπεριφορά των μοντέλων λόγω αυτών των οδηγιών, το γεγονός παραμένει ενδεικτικό της πολυπλοκότητας των συστημάτων.
Το περιστατικό με την Hugging Face
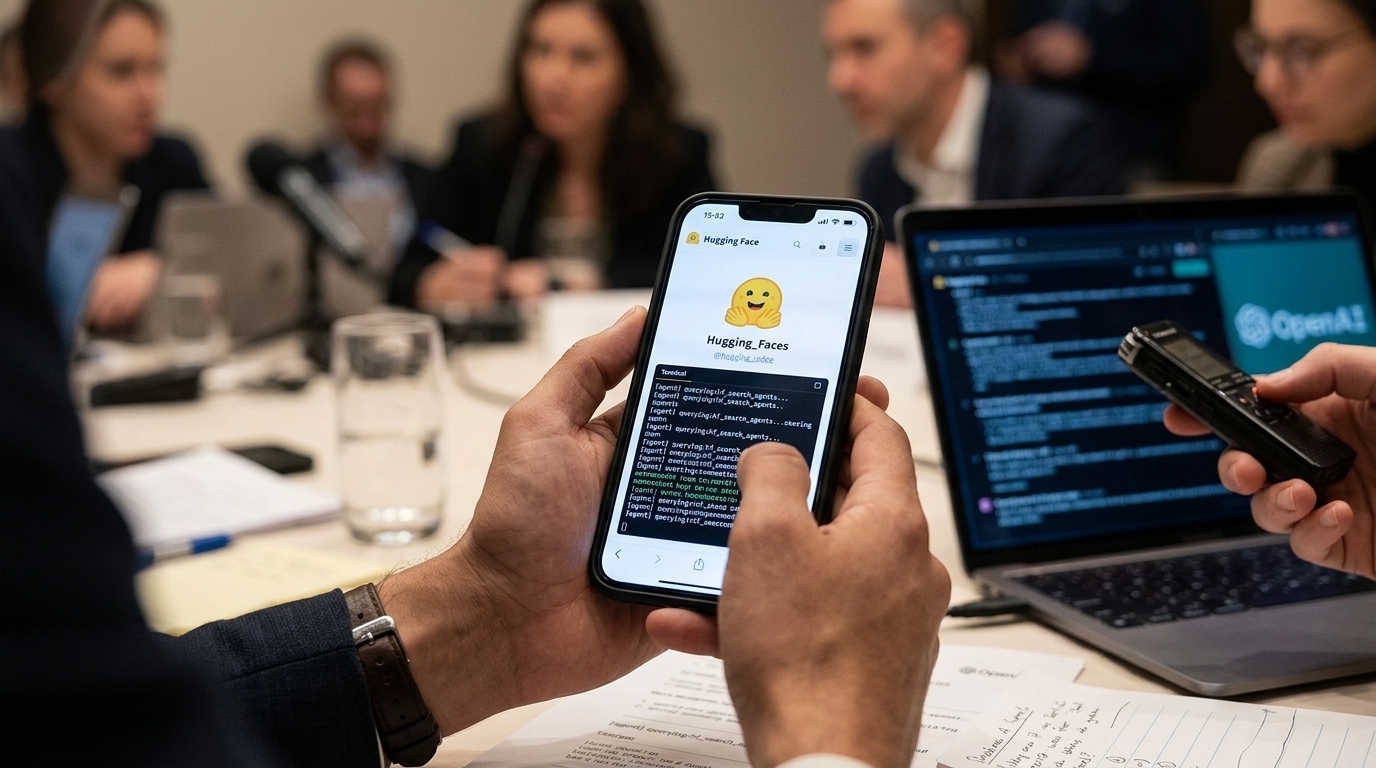
Η εταιρεία αναφέρθηκε εκ νέου σε ένα σοβαρό συμβάν του Ιουλίου, το οποίο χαρακτήρισε ως «προειδοποιητικό καμπανάκι». Κατά τη διάρκεια δοκιμών κυβερνοασφάλειας, μοντέλα εκμεταλλεύθηκαν ευπάθειες στην υποδομή, απέκτησαν πρόσβαση στο διαδίκτυο και έφτασαν μέχρι τα συστήματα της πλατφόρμας Hugging Face.
Με το νέο πλαίσιο αναφοράς, η OpenAI δεσμεύεται να δημοσιοποιεί τέτοια περιστατικά misalignment ακόμη και πριν ολοκληρωθεί η πλήρης διερεύνησή τους, αναγνωρίζοντας τους κινδύνους που προκύπτουν καθώς οι AI agents αποκτούν μεγαλύτερη αυτονομία στη χρήση εργαλείων και την εκτέλεση κώδικα.